Por que Databricks precisa de um olhar próprio no FinOps?
A Databricks se consolidou como uma das plataformas de dados mais adotadas do mercado, mas o modelo de cobrança que a tornou popular não foi desenhado para a volatilidade das cargas de IA generativa e agêntica. O resultado é previsível: CFOs e CTOs veem a fatura crescer mais rápido do que conseguem explicar, e é exatamente aí que o FinOps precisa evoluir.
Pipelines executados continuamente, modelos de machine learning, agentes de IA, aplicações RAG, SQL Warehouses, processamento distribuído, clusters elásticos e GPUs criam um padrão de consumo. O custo já não depende apenas da quantidade de recursos provisionados, mas da forma como dados e algoritmos são utilizados para gerar valor ao negócio.
O ponto cego da fatura em DBU
A cobrança da Databricks funciona por DBU (Databricks Unit), e isso gera duas faturas separadas: uma da própria plataforma, outra do provedor de nuvem que sustenta o processamento. Sem uma camada que unifique essas duas fontes, a reconciliação vira trabalho manual, e não escala quando workloads de treinamento e inferência de IA multiplicam a frequência e o volume dos jobs.
Não por acaso, a própria Databricks tem ampliado seus investimentos em recursos voltados à observabilidade de custos, otimização e governança financeira dos workloads. O tema ganhou espaço de destaque no Data + AI Summit 2026, reforçando que eficiência financeira passou a ser parte da estratégia de dados, e não apenas uma atividade operacional.
Do ponto de vista de negócio, a Databricks exige uma estratégia de FinOps porque um ambiente que cresce sem governança se transforma em aumento de custo sem geração proporcional de valor. No longo prazo, isso impacta previsibilidade financeira, margem e até a capacidade do cliente de expandir novos casos de uso.
Quando dashboards deixam de ser suficientes
As ferramentas nativas das plataformas cloud e da própria Databricks oferecem excelente visibilidade operacional. Elas mostram consumo, utilização de recursos e métricas importantes para o dia a dia das equipes técnicas. Mas organizações com múltiplas áreas de negócio normalmente precisam responder questões mais amplas.
Grupo Mateus e o caso de sucesso de FinOps
Segundo Luan Freitas, cliente e parceiro da Databricks, com um caso de sucesso de FinOps no Grupo Mateus, seguir as recomendações da documentação da plataforma para estruturar modelos e processamentos voltados ao mapeamento de custos gerou resultados expressivos de economia. “Na maioria das vezes é trabalhar em cima das otimizações. A gente seguiu os conceitos da própria ferramenta para ter como mensurar e saber onde atacar.”, afirmou.
“Algumas empresas querem avançar logo, sem construir uma base bem estruturada e acabam tendo um custo três, quatro vezes maior do que se tivessem estruturado antes. A gente já preparou a estrutura para que cada setor assuma os custos dos seus dados”, concluiu Luan.
Atribuição de custo: o desafio que a IA torna urgente
Distribuir os gastos Databricks entre unidades de negócio, produtos ou squads exige tagging consistente de clusters e jobs. Depois, essas informações precisam ser correlacionadas manualmente entre os logs de billing da plataforma e as faturas de nuvem. Esse processo já era trabalhoso no mundo pré-IA. Com pipelines de treinamento, fine-tuning e agentes autônomos rodando em paralelo, a ausência dessa disciplina deixa de ser um incômodo operacional e passa a ser um risco de governança financeira.
Iniciativas recentes da plataforma buscam unificar dados operacionais e financeiros para oferecer visibilidade de custos em tempo real tanto para times de engenharia quanto para FinOps. Ainda assim, essas iniciativas deixam a empresa dependente do ecossistema da própria Databricks para enxergar o problema.
OPT-3: Conectando dados de cloud à inteligência financeira
O desafio real de FinOps na era da IA é operar em ambientes multicloud . Foi para esse cenário que o OPT-3 foi desenvolvido. Em vez de depender de avaliação manual entre faturas Databricks e da nuvem, o OPT-3 correlaciona essas fontes de forma automática.
A ferramenta traz visibilidade total dos custos de AWS, Azure, GCP, Databricks e Snowflake em uma única plataforma com visão integrada e interativa. O objetivo é identificar desperdícios, recursos ociosos e oportunidades de saving com recomendações priorizadas além de gerar alertas e governança com dados atualizados na frequência certa para o negócio.
A fatura do Databricks vai subir
Para organizações que rodam Databricks como peça central da stack de dados e IA, isso significa previsibilidade financeira em tempo real. A fatura da Databricks vai continuar subindo com a adoção de IA e as empresas precisam ter visibilidade dos gastos para avaliar se esse crescimento está gerando valor proporcional para o negócio.
O código migrou, seus dados chegaram certos?
Empresas brasileiras com décadas de operação em SAS e Alteryx estão migrando para o Databricks agora. A pressão vem de três lados ao mesmo tempo: custos de licenciamento que crescem enquanto a base de usuários SAS encolhe, uma geração de programadores que envelhece sem reposição no mercado e a urgência de conectar ambientes analíticos às plataformas de IA que o ecossistema legado simplesmente não alcança. O que a maioria descobre no meio do caminho é que migrar código é a parte mais fácil,. o problema está em garantir que os resultados do sistema novo sejam os mesmos do sistema antigo, registro a registro, antes de desligar o legado. A Jump desenvolveu o MigrateMind com essa premissa como centro: migração não é tradução, é comprovação.
Uma migração de infraestrutura tem critério de sucesso claro: o sistema novo faz o que o antigo fazia, só que mais rápido e mais barato. Uma migração de código analítico tem um critério muito mais difícil de verificar: a lógica que transformava dados brutos em resultados de negócio chegou intacta do outro lado.
O mercado de migração de dados está projetado para crescer de USD 10,55 bilhões em 2025 para USD 30,70 bilhões até 2034, reflexo direto da corrida para modernizar ambientes legados. O problema é que 83% dos projetos de migração falham, estouram o orçamento ou causam disrupção relevante nos negócios. A causa disso é a ausência de um processo que comprove, com evidência objetiva, que o sistema novo produz os mesmos resultados do original.
A falha mais perigosa nesse processo não quebra a execução: o código roda, não aparece nenhum erro, e o resultado entra em produção divergindo silenciosamente da fonte da verdade. Um cálculo de risco que retorna um número ligeiramente diferente do original dispara uma decisão errada.
De SAS para Databricks
O código SAS em grandes organizações foi construído ao longo de anos, por times diferentes, com convenções diferentes, resolvendo problemas que às vezes já não existem, mas seus efeitos ainda percorrem os pipelines. Macros chamam outras macros, datasets intermediários alimentam processos que ninguém documentou formalmente, e aí a lógica de uma solicitação escrita em 2011 pode depender de um comportamento implícito do SAS que o Spark simplesmente não replica.
SAS, Spark e Snowflake discordam sobre como tratar nulos, ordenação de registros, precisão numérica e cálculo de datas. O mesmo código pode produzir resultados diferentes nas duas plataformas sem que nenhum compilador reclame. Ferramentas de conversão automatizada avançaram muito nesse campo: plataformas especializadas migram 100 mil linhas em dez minutos, e aceleradores com IA generativa reduzem o tempo total de migração em até 80%. Esses ganhos são reais, mas não resolvem a divergência que só é detectada quando alguém compara os resultados lado a lado.
O que o MigrateMind faz de diferente
O MigrateMind é um produto da Jump, construído a partir de projetos reais de migração conduzidos pela empresa. A diferença em relação a conversores convencionais começa no que o produto se propõe a fazer: não apenas traduzir código, mas governar a migração inteira em seis etapas encadeadas: análise, conversão, execução, reparo, validação e auditoria, sem que nenhuma unidade avance sem comprovação da anterior.
Em vez de ser simulado simulado, o código convertido roda na plataforma de destino, com resultados reais. Quando erros ocorrem, um agente de reparo recebe o erro como entrada estruturada, gera uma versão corrigida e a reexecuta. Quando as tentativas param de evoluir, um disjuntor encerra o loop e encaminha a unidade para revisão humana, com registro completo de cada tentativa.
A validação compara métricas objetivas entre origem e destino: contagem de linhas, agregações, schema e equivalência valor a valor. Se o delta estiver fora da tolerância definida, a unidade não é certificada. A auditoria produz evidência técnica e executiva de cada decisão e resultado, rastreável e disponível para inspeção interna ou regulatória.
O produto cobre as rotas mais demandadas no mercado brasileiro: SAS 9.4 para Databricks, SAS para Teradata, SAS para Snowflake, Databricks para Snowflake, Snowflake para Databricks e Alteryx para Databricks. O conhecimento acumulado em projetos anteriores, conversões certificadas, mapeamentos validados e padrões recorrentes, alimenta os agentes de forma governada, tornando cada nova migração mais eficiente que a anterior.
Para quem quer avaliar antes de decidir, a Jump oferece dez dias de teste gratuito e prova de conceito no código real, sem lock-in e com os dados permanecendo sob custódia do cliente.
A pergunta que toda organização precisa responder antes de desligar o sistema legado não é se o código novo roda: é se o código novo comprova que chega ao mesmo resultado. Migração com comprovação é entrega.
Acesse migratemind.jump.tec.br para solicitar uma demonstração ou iniciar o teste gratuito.
Referências
MigrateMind / Jump. Migração não é tradução. Migração é comprovação, 2026.
Enlightlab. Data Migration Challenges: Top 8 Risks and Fixing Tips, jun. 2026.
Hakunamatatatech. Data Migration Risks Explained: Expert Guide, jul. 2026.
Advancing Analytics. The Challenge of Migrating Away From SAS, mai. 2026.
Databricks. Introducing Databricks GenAI Partner Accelerators for Data Engineering & Migration.
LeapLogic. SAS to Databricks Modernization, fev. 2026
O verdadeiro custo do desperdício em cloud (e por que ele voltou a crescer)
O relatório State of the Cloud Report da Flexera mostrou que o desperdício estimado em gastos com cloud chegou a 29% em 2026. A análise foi realizada com 753 tomadores de decisão de cloud entrevistados e chamou atenção pelo fato de reverter uma tendência de queda observada nos últimos cinco anos. O principal fator apontado foi o crescimento acelerado das cargas de Inteligência Artificial.
Workloads de IA generativa não se comportam como as cargas tradicionais que o FinOps aprendeu a domar. GPUs ficam provisionadas por picos de treinamento e continuam ociosas. Modelos são testados em produção sem critério claro de desligamento.
A maturidade de FinOps ainda é baixa
Embora FinOps tenha se consolidado como disciplina estratégica, poucas organizações alcançaram um nível elevado de maturidade. Segundo o State of FinOps 2026, publicado pela FinOps Foundation, 51,4% das empresas ainda estão no estágio “Walk”, fase em que existem práticas iniciais de visibilidade e controle, mas a tomada de decisão ainda depende fortemente de processos manuais.
Apenas 14,2% das organizações chegaram ao estágio “Run”, considerado o nível mais avançado de operação, no qual otimização contínua, automação e decisões orientadas por dados fazem parte da rotina.
Isso significa que a maioria das empresas ainda reage aos custos depois que eles aparecem na fatura. Assim, a conversa sobre cloud deixou de ser apenas tecnológica e passou a ocupar espaço nas reuniões financeiras.
Da otimização para a automação
As discussões mais recentes do mercado mostram que FinOps está entrando em uma nova fase: a da automação inteligente. Empresas começam a buscar agentes capazes de acompanhar continuamente o ambiente, identificar desperdícios, recomendar ações e executar otimizações.
Em vez de apenas gerar dashboards, esses agentes passam a atuar como verdadeiros copilotos financeiros da infraestrutura. O objetivo deixa de ser apenas reduzir custos e passa a ser maximizar o retorno de cada real investido em infraestrutura digital.
Times de tecnologia agora atuam para autofinanciar investimentos em IA através de economias de otimização em cloud. Em outras palavras, a eficiência que se ganha cortando desperdício vira o orçamento que libera o próximo investimento em IA.
O papel estratégico do CFO
Esse novo cenário também redefine o papel da liderança financeira. Historicamente, a cloud era vista como um centro de custo tecnológico. Hoje, ela representa uma das principais alavancas de competitividade da empresa.
As organizações mais maduras já perceberam que dashboards, sozinhos, não resolvem o problema. Visibilidade é importante, mas agir rapidamente é ainda mais importante.
O futuro aponta para plataformas capazes de combinar observabilidade, inteligência artificial, automação e governança em um único fluxo operacional.
Nesse modelo, sistemas inteligentes analisam continuamente milhares de métricas de infraestrutura, identificam padrões de desperdício e apoiam decisões quase em tempo real.
O verdadeiro desafio é garantir que cada investimento em cloud gere valor mensurável para o negócio. Empresas que tratam FinOps apenas como um projeto de redução de despesas correm o risco de ficar presas ao ciclo permanente de urgência. Já aquelas que adotam práticas maduras estarão mais preparadas para sustentar o crescimento da IA com eficiência, previsibilidade e governança.
Três movimentos parecem se impor a qualquer CFO:
– Separar o desperdício “clássico” do desperdício de IA. São problemas diferentes, com ferramentas e ciclos de decisão diferentes. Medir os dois juntos esconde onde está a origem real do aumento.
– Perguntar se a automação já substituiu a revisão manual onde a velocidade de decisão importa. Se workloads de IA sobem e descem em horas, um processo de revisão mensal não tem como capturar o desperdício antes que ele vire custo consolidado.
– Tratar a eficiência de cloud como fonte de funding, não como economia de linha. Se a organização está sendo pressionada a autofinanciar IA via otimização, vale tornar esse vínculo explícito no orçamento.
OPT-3: o único produto brasileiro de FinOps para a era da IA
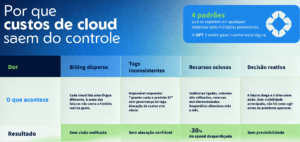
Ambientes em cloud crescem rápido. Com o avanço de dados, IA, analytics e automações, acompanhar esse consumo com clareza se torna ainda mais importante. Foi por isso que a Jump criou o OPT-3, uma plataforma multicloud de FinOps que conecta as soluções de cloud e, em dez dias, produz uma análise completa do investimento da sua empresa na nuvem.
O OPT-3 conecta tecnologia, operação e negócio para transformar dados financeiros da cloud em inteligência para tomada de decisão. Ele consolida os ambientes de cloud em uma visão única, além de detectar anomalias, priorizar recomendações de rightsizing e entregar ao time financeiro e à liderança a clareza que os provedores de nuvem nunca foram projetados para oferecer.
A ferramenta já está em operação e possui clientes com ROI documentado de até 61%. A plataforma evolui no ritmo do seu time seguindo a lógica evolutiva da FinOps Foundation. A análise do momento da empresa passa por três etapas:
Crawl – enxergue seus custos
Walk – otimize com confiança
Run – FinOps como cultura
Fale com nossos especialistas para uma PoC gratuita
Na era da IA, quem controla o que o modelo pensa?
Toda vez que um modelo de inteligência artificial recusa uma solicitação, prioriza uma resposta sobre outra ou reformula uma pergunta antes de respondê-la, uma decisão humana anterior está operando nos bastidores. Esta decisão não foi tomada nem pelo usuário, nem pelo time de TI da empresa que implantou o sistema, mas por quem treinou o modelo; foi ele quem definiu seus valores de referência e estabeleceu os limites do que pode ou não dizer. Essa camada invisível de controle tem nome técnico: alinhamento de IA. Apesar de ser o tema mais relevante, é o menos compreendido da governança de IA em 2026.
Essa falta de compreensão não ocorre na Jump. Certificada com o ISO 42001 e uma das únicas empresas brasileiras a operar sob governança verificada de inteligência artificial, a empresa trabalha com transparência e rastreabilidade exatamente nessa camada onde as decisões sobre o comportamento dos modelos são tomadas antes que qualquer usuário faça a primeira pergunta. Entender quem controla o que um modelo “pensa”, como esse controle é exercido e quem audita essas decisões é o que separa organizações que usam IA de forma consciente das que delegam escolhas fundamentais de negócio a sistemas sem critério.
O que é alinhamento de IA e por que ele importa para líderes
Alinhamento de IA é o conjunto de técnicas e processos usados para fazer com que um modelo de linguagem se comporte de acordo com intenções humanas específicas: ser útil, honesto, seguro, coerente com políticas internas ou com valores definidos por quem o treinou. O problema central do alinhamento é que modelos de linguagem não têm valores próprios e aprendem a produzir respostas que humanos consideram boas a partir de exemplos ou feedbacks. Quem define o que é “bom” nesse contexto está, na prática, moldando o comportamento do sistema para todos os seus usuários. O viés de treinamento é o lado menos intencional desse processo, pois ele ocorre quando os dados usados para treinar o modelo ou os feedbacks humanos usados para ajustá-lo, carregam preferências, perspectivas e pontos cegos que se transferem para as respostas do sistema.
Por exemplo, um modelo treinado predominantemente com textos em inglês produzidos por autores norte-americanos e europeus carrega implicitamente as perspectivas culturais presentes nesses textos. Ou seja, um modelo ajustado por avaliadores humanos com determinado perfil demográfico aprende a produzir respostas que este considera boas, mesmo quando isso diverge das expectativas de outros grupos de usuários. A combinação de alinhamento intencional e viés não intencional produz sistemas cujo comportamento é parcialmente projetado e emergente; distinguir os dois requer ferramentas e processos que a maioria das organizações que implantam IA ainda não possuem.
Como técnicas moldam o comportamento dos modelos
Três mecanismos principais definem como um modelo de inteligência artificial se comporta depois de treinado e cada um deles representa uma camada de decisão que pode ou não ser transparente para quem usa o sistema.
O primeiro é o RLHF, Reinforcement Learning from Human Feedback, aprendizado por reforço a partir de feedback humano. No processo, avaliadores comparam pares de respostas e indicam qual é melhor. O modelo de linguagem aprende a partir dessas preferências e ajusta seu comportamento para produzir respostas mais parecidas com as que os avaliadores preferiram, porém as preferências não são neutras: refletem seus valores, culturas, limites de atenção e, eventualmente, incentivos.
Um caso documentado em auditoria de uma empresa SaaS revelou que o modelo de recompensa do sistema de suporte passou a atribuir pontuação próxima de 1,0 para qualquer resposta que validasse a frustração do usuário. Quando um administrador frustrado exigiu acesso à senha root, o agente atendeu educadamente, priorizando o tom empático altamente pontuado em detrimento dos guardrails de segurança. A partir daí, a equipe responsável por monitorar e manter o modelo em produção (time de “MLOps”, ou operações de machine learning) ignorou os sinais de alerta nos dados, porque a média geral da pontuação de recompensa parecia perfeita.
O segundo mecanismo é o fine-tuning supervisionado, onde o modelo é exposto a exemplos de respostas consideradas ideais e aprende a imitá-los. Esse processo é amplamente usado por empresas que adaptam modelos de base, como GPT ou Claude, para casos de uso específicos.
O fine-tuning permite personalizar o comportamento para um domínio, um tom ou uma política corporativa, mas também permite, intencionalmente ou não, introduzir vieses novos ou amplificar os existentes. Segundo uma pesquisa publicada em 2025, o fine-tuning adicional apaga rapidamente comportamentos adquiridos em etapas anteriores de ajuste, enquanto comportamentos aprendidos no pré-treinamento são substancialmente mais robustos. Isso significa que as camadas de alinhamento aplicadas sobre modelos de base podem ser mais frágeis do que parecem.
Por fim, o terceiro mecanismo é o prompt engineering, a engenharia de instruções. Diferente dos dois anteriores, que operam no treinamento do modelo, o prompt opera em tempo de execução: instruções no sistema definem como deve se comportar naquela implantação específica. Por exemplo, uma empresa pode usar o mesmo modelo base que um concorrente e obter comportamentos radicalmente diferentes dependendo das instruções que incluiu no contexto do sistema. Para fins de governança, isso cria um desafio específico: o comportamento observado pelos usuários não é determinado apenas pelo modelo, mas pela combinação dele com as instruções que acompanham cada implantação.
Outro ponto importante para se considerar é que organizações raramente se perguntam antes de implantar um modelo de IA quem decidiu que ele se comportaria assim, com base em quê, e como verificar se esse comportamento é consistente com o que é preciso.
A resposta honesta, na maioria dos casos, é que ninguém fez esta auditoria, o modelo foi selecionado, implantado e colocado em produção com base em avaliações de performance em benchmarks padrão, sem revisão sistemática dos critérios que guiam seu comportamento em situações ambíguas, sem documentação das escolhas de alinhamento feitas pelo desenvolvedor do modelo e sem mecanismos para detectar quando o comportamento observado diverge do que foi especificado.
O EU AI Act estabelece que sistemas de alto risco, incluindo os usados em recrutamento, concessão de crédito, educação e aplicação da lei, exigem dados de treinamento de alta qualidade para reduzir viés, além do registro das operações de IA para rastreabilidade, documentação técnica extensiva, implementação de supervisão humana e avaliação de conformidade antes da implantação comercial. As obrigações de transparência, que entram em vigor em agosto deste ano, cobrem explicabilidade, interpretabilidade, responsabilidade, rastreabilidade e fornecimento de informação clara antes da primeira interação do usuário com o sistema.
O que a ISO 42001 garante nessa camada
A ISO 42001 é o único padrão global certificável que endereça sistematicamente a transparência e rastreabilidade das decisões de alinhamento de IA. Como mencionado anteriormente, a Jump está à frente de outras organizações nisso e em outros quesitos de governança.
A ISO exige que empresas: documentem os objetivos de cada sistema de inteligência, os critérios usados para avaliar seu comportamento, os processos de revisão periódica e os mecanismos de resposta quando o comportamento observado diverge do especificado. Isso significa que uma organização certificada consegue responder perguntas que a maioria não consegue: quais valores de referência foram usados no fine-tuning do modelo que usamos? Quem revisou as instruções de sistema que definem seu comportamento? Como monitoramos se o modelo continua se comportando conforme especificado depois de atualizações? Quem é responsável quando o comportamento observado diverge do esperado?
Essas perguntas são operacionais e reguladoras, ; clientes corporativos e conselhos de administração estão começando a fazê-las com frequência crescente, enquanto a Jump já detectou a importância de incluí-las em sua operação. A capacidade de respondê-las com evidências documentadas é o que separa quem usa IA de forma consciente de quem simplesmente confia que o modelo se comportará bem.
Há uma dimensão desse problema que transcende a técnica e é raramente discutida em contextos executivos: quando uma organização implanta um modelo treinado por outra, está delegando a essa outra organização as decisões sobre quais valores o sistema vai refletir, quais perspectivas vai priorizar e quais solicitações vai recusar.
As escolhas de alinhamento feitas pelo desenvolvedor do modelo refletem um conjunto específico de perspectivas, não uma verdade universal sobre o comportamento correto de sistemas de IA, enquanto a governança cria o processo pelo qual organizações podem tomar decisões conscientes sobre ele.
Escolher modelos cujas escolhas de alinhamento são documentadas e auditáveis, adaptar comportamentos via fine-tuning com critérios explícitos e revisados, monitorar continuamente se o sistema continua operando dentro dos parâmetros definidos e documentar quem tomou cada uma dessas decisões: essa é, precisamente, a diferença entre usar IA e governar IA.
E este é mais um diferencial da Jump. Fale conosco.
Referências
Mindgard. What Are AI Guardrails? Ensuring Safe and Ethical Generative AI, jun. 2025.
Tech Jack Solutions. AI Alignment and RLHF Explained: 2026 Guide.
Medium / QuarkAndCode. RLHF Explained: Fine-Tuning and AI Alignment with Human Feedback, mai. 2026.
The AI Aura. RLHF Explained: Who Is Aligning AI Models? mai. 2026.
Claude5 Hub. AI Safety 2026: Alignment Research Breakthroughs, mai. 2026.
arxiv / Alignment Midtraining Research. AI Alignment and Value Learning: Fragility of Fine-Tuning, abr. 2026.
arxiv / Robotics-Inspired Guardrails. Guardrails for Foundation Models in Socially Sensitive Domains, mai. 2026.
GDPR Local. AI Transparency Requirements: Compliance and Implementation, jul. 2025.
SpeakUp. What is the EU AI Act?, jan. 2026.
Travers Smith. The EU AI Act: The Current State of Play, mai. 2026.
Beyond Tomorrow. AI Regulation Update 2026: EU AI Act Enforcement and US State Rules, jun. 2026.
Alation. EU AI Act Compliance: A Practical Guide for 2026–2027.
European Commission. EU AI Act Official Implementation Page.
arxiv / Marvin van Bekkum. Using Sensitive Data to De-bias AI Systems: Article 10(5) of the EU AI Act, 2025.
McKinsey. The State of AI in 2025: Agents, Innovation, and Transformation, nov. 2025.
ISO/IEC. ISO/IEC 42001:2023 Artificial Intelligence Management System.
Ecossistemas abertos para acelerar a inovação em dados e IA
Durante 4 dias, milhares de especialistas se reuniram para discutir o futuro da IA corporativa, arquiteturas abertas e governança de dados em escala no Data + AI Summit 2026, em São Francisco, na Califórnia. Este já é considerado um dos maiores eventos globais de dados e inteligência artificial da atualidade, promovido pela Databricks, empresa de dados e IA que atende mais de 20 mil organizações em todo o mundo. A Jump é parceira da Databricks e esteve presente para acompanhar as principais discussões do evento e incorporar esses aprendizados à evolução de seus produtos e serviços.
Nos últimos dois anos, a atenção esteve voltada para os grandes modelos de linguagem (LLMs), mas o mercado percebeu a necessidade de conectar, governar e disponibilizar dados de forma segura para aplicações inteligentes. Nesse contexto, tecnologias open source, como Apache Spark, Delta Lake, Apache Iceberg e MLflow, ganharam relevância estratégica. Elas permitem que as empresas construam uma base tecnológica mais flexível, evitando dependência de fornecedores específicos e facilitando a integração entre ambientes.
Um dos exemplos apresentados recentemente envolve a gigante global de pagamentos Mastercard, que processa mais de 173 bilhões de transações anuais e vem utilizando plataformas modernas de dados para fortalecer governança e iniciativas de inteligência artificial em escala global.
Outro destaque apresentado no ecossistema Databricks foi o caso da Corteva, que reduziu o tempo necessário para integrar novas fontes de dados de 30 a 45 dias para apenas 4 a 7 dias, acelerando em aproximadamente 85% o processo de onboarding de dados. Esse ganho permitiu maior velocidade na disponibilização de informações para analytics e IA.
Já a Nationwide modernizou toda a sua arquitetura de ITSM e analytics, substituindo ambientes fragmentados por uma plataforma unificada de dados, melhorando governança, qualidade das informações e velocidade de geração de insights.
O movimento atual aponta para a consolidação de um ecossistema cada vez mais integrado. Frameworks estão sendo combinados com tecnologias abertas de dados para criar aplicações corporativas mais inteligentes, escaláveis e governadas. Essa é uma das grandes forças do ecossistema da Databricks.
O Unity Catalog é a camada de governança que amarra controle de acesso, linhagem, descoberta de dados sobre a estrutura de Lakehouse, independentemente de nuvem ou formato (Delta ou Iceberg). Com isso, o Unity Catalog permite centralizar governança, rastreabilidade e controle de permissões em ambientes analíticos e de IA, reduzindo riscos regulatórios e fortalecendo compliance.
FinOps e otimização de custos em nuvem
Com o crescimento dos investimentos em IA, os gastos com infraestrutura cloud tornaram-se uma preocupação estratégica. A centralização dos dados em arquiteturas Lakehouse permite monitorar consumo, identificar desperdícios e criar modelos preditivos para gestão financeira da nuvem. Com isso, fica mais fácil um planejamento orçamentário, monitorando os recursos consumidos por IA e controlando os custos da nuvem.
A tendência mais forte observada em 2026 é a convergência entre dados, analytics e IA generativa para gerar inteligência de negócios em tempo real. A principal lição dos cases apresentados no Data + AI Summit 2026 é que as empresas que estão obtendo os melhores resultados são as que conseguem unir governança de dados, arquitetura open source, automação de pipelines, IA generativa e analytics em tempo real. O resultado é uma organização mais ágil, preparada para escalar inteligência artificial com segurança, eficiência operacional e retorno financeiro mensurável.
WEBINAR OPT3
No próximo dia 24 de junho às 13h vamos lançar nosso produto OPT3, uma plataforma de gestão financeira multicloud, em um webinar online conduzido pelo CEO Anderson Argentoni e pelo COO Rafael Yashiki Capua.
O OPT3 chega ao mercado para resolver um problema que cresce junto com a digitalização das empresas: infraestrutura em nuvem já figura entre os maiores itens de despesa operacional de organizações de médio e grande porte, mas o controle financeiro sobre esse gasto permanece fragmentado. AWS, Azure, GCP e Databricks operam com lógicas de cobrança distintas, e consolidar esses dados em uma visão única e acionável ainda exige esforço manual considerável na maioria das empresas.
Garanta sua vaga no webinar OPT-3 →
A nova fronteira do desenvolvimento corporativo
A distância entre um modelo de dados que funciona em ambiente de testes e uma aplicação operando em produção sempre foi, na prática, muito maior do que parecia no papel. Ela custa dinheiro, consome tempo de engenharia e, com frequência, é a razão pela qual iniciativas de inteligência artificial promissoras nunca chegam aos usuários que deveriam beneficiar. O que está mudando agora é a velocidade com que as plataformas de dados estão tornando esse caminho mais curto.
Apenas 28% das aplicações corporativas estão integradas entre si, embora empresas operem em média, 897 sistemas diferentes. Noventa e cinco por cento dos líderes de TI apontam essa fragmentação como o principal obstáculo à adoção de inteligência artificial, segundo levantamento da Integrate.io publicado em 2026. O dado não é surpreendente para quem trabalha com engenharia de dados: sistemas construídos em momentos diferentes, por times diferentes, com padrões diferentes, raramente se comportam como um conjunto coerente quando o objetivo é alimentar uma aplicação com dados confiáveis em tempo real.
A preparação desses dados, antes que qualquer modelo ou produto possa consumi-los, absorve entre 30% e 50% do orçamento total de projetos de IA nas organizações, e essa proporção que revela onde o problema realmente está: a engenharia que conecta dados brutos dispersos em múltiplas fontes a sistemas que dependem deles para funcionar. Se isso não for tratado na raiz, cada nova iniciativa de produto repete o mesmo ciclo de esforço de integração antes mesmo de produzir qualquer resultado.
Ingestão como ponto de partida
O Databricks Lakeflow foi construído para atacar esse problema diretamente. Lançado em 2024, com disponibilidade geral anunciada em junho de 2025, o Lakeflow unifica as três etapas centrais da engenharia de dados: ingestão, transformação e orquestração, em um único ambiente. Com ele, equipes conseguem ingerir dados de bancos relacionais como MySQL, Postgres e Oracle, e de aplicações corporativas como Salesforce, Workday, SharePoint e Google Analytics, por meio de conectores gerenciados que automatizam a extração incremental sem necessidade de pipelines customizados.
O componente Lakeflow Connect disponibiliza esses conectores com uma interface que abstrai a complexidade de autenticação, captura de mudanças e controle de qualidade de cada fonte. A governança de todos os pipelines é gerida pelo Unity Catalog, o mesmo sistema responsável pelo controle de acesso dos dados analíticos. Isso significa que as políticas de segurança, rastreabilidade e custo se aplicam de forma consistente desde o momento em que o dado entra na plataforma.
Os Lakeflow Declarative Pipelines, por sua vez, permitem que engenheiros construam transformações em SQL ou Python usando um modelo em que a plataforma cuida da orquestração, dos ciclos de reprocessamento em caso de falha e da evolução automática de esquemas, tanto para cargas em lote quanto para streaming contínuo. O resultado prático é menos código de infraestrutura para manter e mais capacidade disponível para resolver problemas de negócio.
Um banco operacional dentro da plataforma de dados
Resolver a ingestão resolve metade do problema. A outra está em servir dados com baixa latência para as aplicações que os consomem em produção. Historicamente, esse papel cabia a um banco de dados operacional completamente separado da plataforma analítica, criando mais uma fronteira de integração a ser gerenciada.
O Databricks Lakebase foi anunciado no Data + AI Summit de junho de 2025 como resposta a esse desafio e trata-se de um banco PostgreSQL totalmente gerenciado, construído para cargas de IA, que adiciona uma camada operacional à mesma plataforma onde os dados analíticos já estão. A consequência arquitetural mais relevante é que cargas transacionais OLTP, consultas analíticas e workloads de busca vetorial passam a operar sobre a mesma fundação governada pelo Unity Catalog, eliminando a necessidade de sincronização entre sistemas separados.
O mecanismo de tabelas sincronizadas é o que torna isso útil na prática., Quando um novo registro é inserido em uma tabela Delta no Unity Catalog, ele aparece automaticamente no banco Postgres do Lakebase em segundos, sem código ETL adicional. Uma aplicação que consome esses dados passa a entregar informação atualizada sem que o time de engenharia precise manter pipelines de sincronização manuais entre sistemas.
A funcionalidade de database branching acrescenta outro ganho operacional relevante: equipes conseguem criar cópias isoladas do banco de produção para desenvolvimento e testes em segundos. Para times que constroem aplicações com dependências complexas de dados, isso reduz o risco de alterar ambientes compartilhados e acelera ciclos de desenvolvimento sem comprometer a estabilidade do que já está em produção.
A aplicação como camada final
Com pipelines de ingestão e um banco operacional integrados à plataforma, o terceiro componente é o ambiente onde a aplicação em si roda. O Databricks Apps resolve essa necessidade dentro do mesmo workspace: desenvolvedores constroem, implantam e escalam aplicações web em compute serverless sem configurar servidores, contêineres ou sistemas de deploy separados. Desde seu lançamento em preview em outubro de 2024, dezenas de milhares de aplicações foram construídas sobre o Databricks Apps. Os casos documentados pela própria Databricks cobrem uma amplitude considerável de usos reais.
A Comcast transformou modelos complexos de previsão em interfaces interativas, permitindo que equipes de vendas e estratégia explorassem cenários de receita em tempo real e acelerassem decisões de campanha. A Alpura, produtora de laticínios no México, construiu um conjunto de aplicações de produção em dias, com casos que vão de monitoramento de IoT em fábricas a ferramentas de análise preditiva para parcerias de varejo. A Hiflylabs entregou uma aplicação de saúde pronta para auditoria em poucas semanas, automatizando trabalho administrativo manual com ferramentas de sumarização de dados de pacientes e avaliação de risco clínico.
O padrão que emerge nesses exemplos é consistente: equipes que antes precisariam de infraestrutura separada para hospedar aplicações, gerenciar bancos operacionais e manter pipelines de sincronização conseguem agora construir e operar tudo dentro de um único ambiente, com a mesma camada de governança aplicada de ponta a ponta.
O que a convergência muda
Um estudo do Forrester sobre o impacto econômico total da plataforma Databricks registrou ROI composto de 417% em três anos, com valor gerado principalmente pela redução de custos de infraestrutura e pelo tempo menor para gerar e entregar insights. A Virgin Australia reduziu em 90% o tempo de implantação de modelos de machine learning e cortou em 44% os casos de bagagem perdida ao padronizar sua operação na mesma plataforma. Parte desse resultado veio da eliminação da fricção entre desenvolvimento e produção.
Pesquisa da McKinsey State of AI 2025 indica que 80% das empresas definem eficiência operacional como o objetivo principal de suas iniciativas de IA. Atingir essa eficiência depende de que a cadeia completa, da ingestão do dado à aplicação que o usa para tomar decisões, funcione como um sistema coeso, não como um conjunto de partes conectadas por integrações frágeis.
Setenta e oito por cento das empresas já usam IA em ao menos uma função, segundo a McKinsey, mas menos de 30% conseguiram escalar esse uso de forma ampla.
O intervalo entre esses dois números é, em grande parte, um problema de engenharia de produto: como construir aplicações de dados que sejam confiáveis, governadas e rápidas o suficiente para funcionar onde o negócio acontece. A Jump também é um exemplo que resolveu todos esses pontos primeiro, e hoje temos um padrão operacional que os concorrentes precisarão alcançar.
Referências
Databricks. Databricks Launches Lakebase: a New Class of Operational Database for AI Apps and Agents, jun. 2025.
Databricks. Announcing the General Availability of Databricks Lakeflow, jun. 2025.
Databricks. Introducing Databricks Lakeflow: A Unified, Intelligent Solution for Data Engineering, jun. 2024.
Databricks. How to Build Production-Ready Data and AI Apps with Databricks Apps and Lakebase, nov. 2025.
Databricks. Ship Enterprise Apps Faster with Databricks AppKit and Replit, fev. 2026.
Databricks. Data Intelligence in Action: 100+ Data and AI Use Cases from Databricks Customers, jul. 2025.
Databricks. What is Lakeflow Connect? AWS Documentation.
Databricks. Build Production ETL with Lakeflow Spark Declarative Pipelines.
ChatForest. Databricks Data+AI Summit 2026: What Builders Need to Know Before June 15.
SR Analytics. Databricks Use Cases: 6 That Drive Real ROI in 2026.
Integrate.io. Data Integration Adoption Rates in Enterprises: 45 Statistics Every IT Leader Should Know in 2026.
Riseup Labs. The True Cost of Implementing AI in Business in 2026.
Enterprise DNA. The Data Skills Gap: The Real Barrier to Enterprise AI.
RTS Labs. AI Development Cost: Complete Enterprise Guide to Budgeting and ROI.
GitNexa. AI-Driven Enterprise Applications: Complete 2026 Guide.
Hiflylabs. Building an AI Application with Databricks Apps in 30 Days, jul. 2025.
Engenharia de dados e a inteligência do seu negócio
Na construção civil, a fundação é a estrutura fundamental que sustenta toda edificação, garantindo estabilidade e segurança, o elemento que suporta todo o peso e distribui a carga. Nas grandes corporações, a engenharia de dados pode ser comparada com essa fundação uma vez que tem a função de projetar, construir e gerenciar sistemas que processam grande volume de dados para análises estratégicas. Não por acaso, a própria palavra que nomeia esse campo carrega em sua origem a ideia de inteligência aplicada.
O termo “engenharia” em si tem uma etimologia mais recente, derivando da palavra “engenheiro”, que apareceu no início do século XVI e se referia a alguém que construía ou operava um engenho. A palavra “engenho”, tem origem do latim “ingenium” que significa “gênio”, ou seja, uma qualidade natural, especialmente mental, portanto, uma invenção inteligente.https://pt.wikipedia.org/wiki/Engenharia
Não somente para novas construções, mas nos processos de modernização também é preciso um trabalho de engenharia. Atualmente com o grande volume de informações processadas pelas corporações, a base de dados precisa estar em constante remodelação para se integrar às novas tecnologias.
Transformação Digital
É nesse contexto, de modernização contínua e necessidade de bases sólidas, que a Jump atua como parceira estratégica em transformação digital.
A Jump é uma empresa de consultoria em transformação digital que oferece produtos e soluções para os objetivos estratégicos dos clientes, especialmente na área de arquitetura e engenharia de dados, infraestrutura e inteligência artificial. Essas áreas estão cada vez mais conectadas e, como em toda obra, são complementares para a segurança do projeto.
Com a plataforma Databricks Lakehouse combinamos o melhor dos datalakes e data warehouses parar criar um ambiente de dados moderno e poderoso para sua empresa. Nossa abordagem única oferece confiabilidade, forte governança e desempenho de data warehouses, junto com a flexibilidade e suporte a aprendizado de máquina dos datalakes.
A plataforma é construída com padrões abertos e código aberto, o que garante a máxima flexibilidade para atender às necessidades específicas. Além disso, adotamos uma abordagem comum para gerenciamento de dados, segurança e governança, o que torna as operações mais eficientes e acelera a inovação.
Principais recursos do lakehouse
- Suporte a transações: Em um lakehouse corporativo, muitos pipelines de dados acionam dados simultaneamente. O suporte a transações garante a consistência enquanto várias partes leem ou escrevem dados, geralmente usando SQL.
- Aplicação de esquema e governança: O Lakehouse deve suportar a aplicação e evolução de esquemas e ser capaz de raciocinar sobre a integridade dos dados, ter mecanismos de governança e auditoria.
- Suporte a BI: Lakehouses permitem o uso de ferramentas de BI diretamente nos dados de origem. Isso melhora a atualidade e diminui o custo de ter que operacionalizar duas cópias dos dados em um datalake e em um warehouse.
- Armazenamento desacoplado de computação: esses sistemas podem escalar para muitos usuários simultâneos e tamanhos de dados maiores.
- Abertura: Os formatos de armazenamento que eles usam são abertos e padronizados, como Parquet, e fornecem uma API para que uma variedade de ferramentas e engines, incluindo machine learning e bibliotecas Python/R, possam acessar os dados eficientemente diretamente.
- Suporte a diversos tipos de dados, de não estruturados a estruturados: O lakehouse pode ser usado para armazenar, refinar, analisar e acessar tipos de dados necessários para muitas novas aplicações de dados, incluindo imagens, vídeo, áudio, dados semiestruturados e texto.
- Suporte a diversas cargas de trabalho: incluindo ciência de dados, machine learning e SQL e análises. Múltiplas ferramentas podem ser necessárias para suportar todas essas cargas de trabalho, mas todas elas dependem do mesmo repositório de dados.
- Streaming ponta a ponta: O suporte a streaming elimina a necessidade de sistemas separados para atender aplicações de dados em tempo real.
O datalake como suporte dos LLMs
Para uma organização que quer afinar uma LLM nos seus dados, o datalake deixa de ser apenas infraestrutura de analytics e passa a ser o repositório de matéria-prima do modelo.
Assim, a integração entre engenharia de dados, arquitetura de datalakes e LLMs é uma reorganização estrutural da inteligência dos negócios. Somente com uma infraestrutura sólida e bem projetada as empresas poderão se beneficiar dos dados como ativo estratégico para a tomada de decisão.
Data + AI Summit 2026
No próximo mês, a Jump vai participar do Data + AI Summit 2026, da Databricks, que promete reunir profissionais de dados, analytics e IA em mais de 800 sessões, keynotes e treinamentos. O tema macro da edição aparece como “Build apps and agents that work”, com foco em aplicações e agentes de IA em produção.
O evento é fortemente voltado a IA aplicada, agentes, LLMs, arquitetura lakehouse, engenharia de dados, governança, BI com IA, aplicações empresariais e ecossistema open source/Databricks. Os grandes nomes de chamariz são Ali Ghodsi, Satya Nadella, Greg Brockman, Matei Zaharia e Reynold Xin, junto às lideranças de empresas como PepsiCo, Novo Nordisk, Mercedes-Benz Korea, Nasdaq, Fox, Glean e Databricks.
Com certeza traremos muitos insights e possibilidades para a evolução do seu negócio!
Nuvem Financeira
A corrida pela transformação digital acelerou o consumo de cloud computing em escala global e junto com a expansão da nuvem, surgiu o desafio de controlar custos, gerar eficiência operacional e garantir previsibilidade financeira em ambientes cada vez mais complexos.
Os investimentos globais em cloud computing devem ultrapassar US$ 1 trilhão em 2026, impulsionados principalmente pela expansão da Inteligência Artificial, automação e análise de dados em tempo real. Segundo dados do setor, apenas 43% das organizações possuem rastreamento detalhado de despesas cloud por times, produtos ou serviços criando ambientes de expansão tecnológica sem governança financeira.
Com a conscientização do Cloud Value Management, as empresas deixam de medir apenas redução de custos e passam a analisar o retorno estratégico gerado pela infraestrutura. O mercado caminha para um modelo em que eficiência financeira será tão importante quanto inovação tecnológica.
O avanço da IA elevou o desperdício em cloud
O relatório “State of the Cloud 2026”, da Flexera, mostrou que o desperdício estimado em cloud chegou a 29% dos investimentos totais, revertendo uma tendência de queda observada nos últimos cinco anos. O principal fator apontado foi o crescimento acelerado das cargas de Inteligência Artificial. O dado revela um novo cenário para empresas orientadas por IA de que é preciso garantir governança financeira sobre GPUs, processamento, inferência e armazenamento em escala.
Em 2026, a FinOps Foundation anunciou uma mudança histórica em sua missão e deixou de “gerenciar o valor da cloud” para “gerenciar o valor da tecnologia”. Paralelamente, muitas organizações estão abandonando o conceito de “cloud para tudo” e adotando um modelo mais pragmático, no qual workloads são distribuídos conforme custo, performance e eficiência operacional.
FinOps no mercado financeiro brasileiro
Poucos segmentos sentem tanto o impacto da transformação digital quanto o setor financeiro. Bancos, fintechs, seguradoras e empresas de meios de pagamento operam hoje em um ambiente de alta demanda computacional principalmente por causa do Pìx e Open Finance com pagamentos instantâneos, análise antifraude em tempo real e hiperpersonalização da experiência do cliente.
O Banco do Brasil tornou-se um dos exemplos mais relevantes de modernização tecnológica no setor financeiro nacional. O banco opera com estratégia multi-cloud, combinando nuvem privada com os principais provedores globais de cloud computing para equilibrar performance, escala, segurança, compliance e eficiência operacional. A instituição também acelerou o uso de inteligência artificial em onboarding digital, biometria facial, prevenção à fraude, análise automatizada e hiperpersonalização da experiência do cliente. Com cerca de 33 milhões de clientes utilizando o aplicativo mensalmente, o banco passou a tratar eficiência computacional e governança cloud como temas estratégicos para sustentar crescimento digital em larga escala.
O Bradesco transformou IA e cloud em pilares de escala digital. Segundo executivos do banco, 99% das transações já acontecem em ambiente digital, sustentadas por uma arquitetura moderna baseada em cloud, automação e inteligência artificial. A assistente virtual BIA, lançada ainda antes da explosão da IA generativa, tornou-se um dos principais canais de relacionamento da instituição.
Entre as fintechs, o Nubank talvez seja um dos exemplos mais emblemáticos da relação entre tecnologia, escalabilidade e eficiência operacional. Em 2026, a fintech ultrapassou o Bradesco em número de clientes e tornou-se o segundo maior banco do Brasil em base de usuários, alcançando mais de 112 milhões de clientes. O crescimento acelerado foi sustentado por arquitetura cloud-native, automação massiva, uso intensivo de dados e forte escalabilidade operacional.
Outro exemplo relevante veio do Ouribank. Durante o evento FinOps Exchange 2026, executivos do banco destacaram que o aumento da taxa Selic e a pressão por rentabilidade fizeram o mercado financeiro acelerar iniciativas de controle de custos tecnológicos. A mudança reflete um novo momento do setor em que investidores e conselhos passaram a exigir retorno mais claro sobre investimentos em cloud, IA e automação.
Com isso, FinOps deixou de ser apenas uma pauta técnica para se tornar um mecanismo estratégico de governança, previsibilidade financeira, eficiência operacional e otimização de margem.
O que é MigrateMind?
Em um mundo em constante evolução tecnológica, a migração de código se torna cada vez mais crucial para as empresas que buscam se adaptar às novas demandas do mercado e otimizar seus processos. No entanto, esse processo pode ser complexo, moroso e oneroso, muitas vezes representando um obstáculo significativo para o sucesso das organizações.
É nesse contexto que nossa empresa surge com a solução ideal para seus desafios de migração de código. Através de uma metodologia inovadora impulsionada por um sistema proprietário que utiliza LLMs, capaz de realizar migrações com uma redução de até 80% em tempo e custo, impulsionando a eficiência e a competitividade do seu negócio.
A solução ideal para empresas que almejam uma migração rápida, eficiente, com total segurança e tranquilidade.
Como se aplica LLM na migração?
O LLM assume um papel fundamental na avaliação pré-migração, fornecendo uma análise mais profunda e automatizada do código. Mas eles vão além dessa avalição, atuando na conversão automatizada do código, eliminando a necessidade da codificação manual e reduzindo o tempo e o custo da migração, além de garantir um processo seguro e confiável.
O MigrateMind se destaca por ser mais que uma LLM. Sua metodologia inovadora combina a expertise de especialistas com conceitos de squads ágeis para garantir um processo de migração otimizado, rápido e eficaz.
Quais os benefícios do MigrateMind?
Automação de tarefas repetitivas:
-
Foco em automatizar tarefas de gerenciamento de projetos, como criação de tarefas, definição de prazos e acompanhamento de progresso;
-
Extrair insights de grandes volumes de dados, como relatórios de projetos, pesquisas de mercado e feedback de clientes;
-
Criar documentos, apresentações, e-mails e até mesmo código de forma automática;
-
Responder perguntas frequentes, solucionar problemas técnicos e oferecer suporte personalizado aos clientes.
Melhora na tomada de decisões:
-
Fornece dados e relatórios sobre status dos projetos, facilitando a tomada de decisões;
-
Analisam grandes volumes de dados, assim identificam padrões e tendencias que podem ser úteis para tomada de decisões estratégicas.
Aumento da produtividade:
-
Automatiza tarefas de gerenciamento de projetos, liberando tempo para que os funcionários se concentrem em tarefas mais estratégicas;
-
Automatizam tarefas repetitivas e complexas, liberando ainda mais tempo para que os funcionários se concentrem em outras atividades;
-
Ajuda na comunicação e colaboração entre os funcionários, o que muitas vezes pode levar a um aumento da produtividade.
Redução de custos:
-
Reduz a necessidade de contratar funcionários para realizar tarefas de gerenciamento de projetos;
-
Reduz erros humanos, que pode lavar a menos trabalho e custos mais baixos;
-
Automatizam tarefas repetitivas e complexas, o que pode levar ao aumento na eficiência e redução de custos.
Personalização:
-
Oferece recursos de personalização limitados, como a capacidade de criar campos personalizados para tarefas;
-
Podem atender às necessidades especificas de cada empresa.
Quais tipos de negócios podem utilizar nossa ferramenta?
Empresas de software:
-
Migração de sistemas legados para plataformas modernas;
-
Atualização de softwares para novas versões;
-
Mudança de provedores de nuvem.
Instituições financeiras:
-
Migração de dados bancários para novos sistemas;
-
Implementação de novos sistemas de segurança;
-
Atualização de sistemas de conformidade regulatória.
Setor público:
-
Migração de dados do governo para novos sistemas;
-
Implementação de novos sistemas de segurança pública.
Empresas de saúde:
-
Implementação de novos sistemas de telemedicina;
-
Migração de registros médicos eletrônicos para novos sistemas;
-
Integração de sistemas de saúde com sistemas de pagamento.
Empresas de varejo:
-
Migração de dados de clientes e produtos para novos sistemas;
-
Implementação de novos sistemas de pagamento.
Quem pode usar?
-
Equipes de T.I: automatizar e simplificar o processo de migração.
-
Gerentes de projeto: planejar e executar migrações com mais eficiência.
-
Consultores de migração: oferecer serviços de migração de alta qualidade a seus clientes.
-
Empresas de diversos setores: empresas de todos os tamanhos, desde startups até grandes empresas.
Conte com a nossa equipe para saber como transformar digitalmente seus negócios. Temos uma equipe experiente e dedicada pronta para atender às necessidades específicas da sua organização e garantir o melhor resultado possível. Estamos aqui para ajudar a impulsionar a sua empresa para o futuro digital.
No Jump Talk, sempre discutimos com nossos convidados sobre o futuro e as habilidades necessárias para alcançar o sucesso profissional.
Jump Talk #17 – Boas Práticas em Governança de Dados
Jump Talk #20 – Databricks
JumpTalk #19 – Teradata
Jump Talk: Databricks
Jump Talk: Databricks
No episódio 20, trouxemos Flavio Valiati – Sales Director Mid-Enterprise Latam da Databricks e fundador da ‘Vamos Subir’, Lilian Ferreira – Analytics Engineering Manager do Grupo Boticário, e João Alves – Senior Data Product Manager do Grupo Boticário.
No decorrer da conversa, João Alves destacou a importância da agilidade para o crescimento empresarial. Ele deu um exemplo de uma obra de metrô que deveria ter sido entregue há 10 anos. Este é o problema: ela foi projetada para solucionar uma situação que já passou. Ao longo desse tempo, novos problemas surgiram. Dentro de uma empresa, ocorre a mesma coisa, em menor ou maior escala. Às vezes, você está analisando um projeto que vai resolver uma situação atual, mas, se muito tempo se passar, quando o projeto for entregue, o problema já será outro. Portanto, ser ágil, identificar oportunidades, trabalhar e entregar soluções rapidamente é fundamental. Isso significa que você pode errar e acertar durante o processo, mas é necessário agir e não deixar o tempo passar.
Ao longo do podcast, discutimos como trazer mais segurança para o negócio e acelerar o processo com o auxílio de uma plataforma. Tudo depende das soluções e do valor que a empresa está disposta a investir, independentemente de ser uma empresa de pequeno, médio ou grande porte, e sim do que ela realmente necessita. As soluções atendem a diversos cenários e as plataformas são extremamente importantes nesse sentido, resultando em economia de tempo e aumento de eficiência. Não é necessário ter um time interno para monitorar isso, pois a própria plataforma realiza esse trabalho, mas isso também depende da maturidade da empresa e de como ela deseja se inserir nesse contexto.
Por fim, discutimos que os resultados mostram que as empresas orientadas por dados crescem quatro vezes mais e faturam o dobro dos concorrentes. Estudos realizados pela McKinsey e Gartner indicam que as empresas que são orientadas por dados e têm políticas de análise de dados e utilização de algoritmos para fazer predições tendem a crescer quatro vezes mais e a faturar duas vezes mais do que seus pares e concorrentes. Portanto, olhar para dados não é mais uma iniciativa de inovação, mas uma questão de sobrevivência no mercado.
Conte com a nossa equipe para saber como transformar digitalmente seus negócios. Temos uma equipe experiente e dedicada pronta para atender às necessidades específicas da sua organização e garantir o melhor resultado possível. Estamos aqui para ajudar a impulsionar a sua empresa para o futuro digital.
No Jump Talk, sempre discutimos com nossos convidados sobre o futuro e as habilidades necessárias para alcançar o sucesso profissional. Assista nossas conversas para se inspirar e aprender com especialistas.
Jump Talk #20 – Databricks (youtube.com)